Showing 120 of 120on this page. Filters & sort apply to loaded results; URL updates for sharing.120 of 120 on this page
[论文评述] Efficient Token Compression for Vision Transformer with Spatial ...
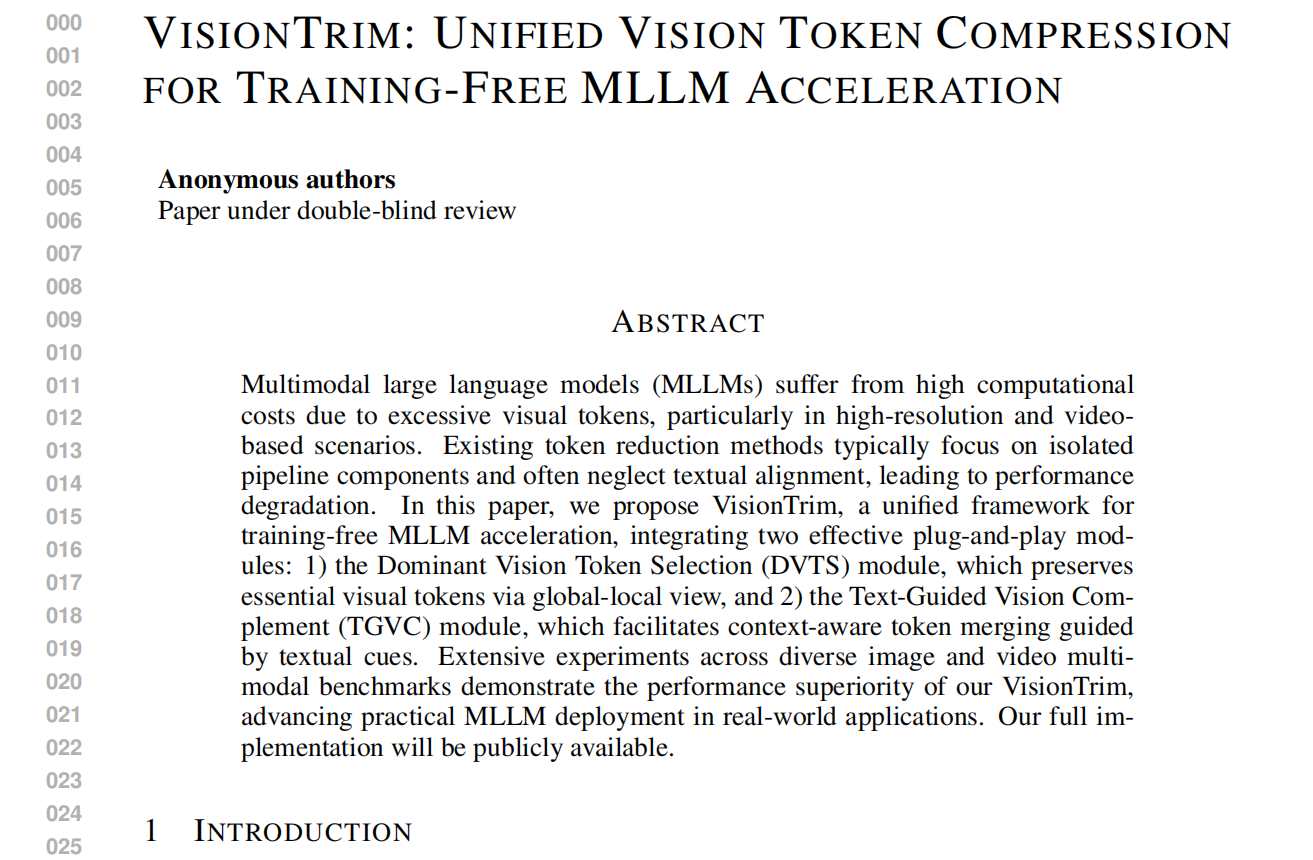
VisionTrim: Unified Vision Token Compression for Training-Free MLLM ...
Adaptive-VoCo: Complexity-Aware Visual Token Compression for Vision ...
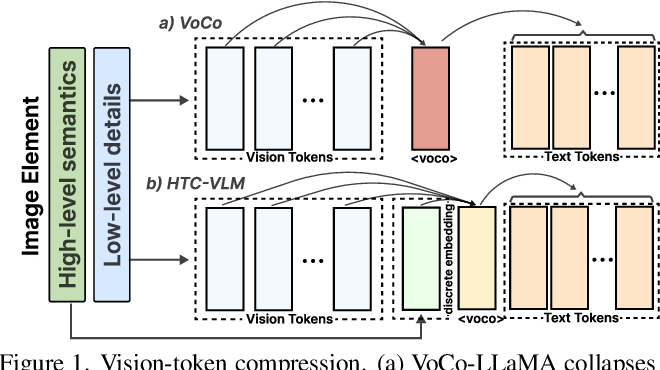
Figure 1 from HybridToken-VLM: Hybrid Token Compression for Vision ...
Efficient Token Compression for Vision Transformer with Spatial ...
DeepSeek-OCR's Vision Token Compression Could Revolutionize How LLMs ...
Towards Lossless Ultimate Vision Token Compression for VLMs | AI ...
Token Compression Meets Compact Vision Transformers: A Survey and ...
Paper page - VisionTrim: Unified Vision Token Compression for Training ...
LightKV: Prompt-Guided Vision Token Compression for Efficient LVLM ...
Token Compression Meets Compact Vision Transformers: Survey and ...
Prune Redundancy, Preserve Essence: Vision Token Compression in VLMs ...
[论文评述] PVC: Progressive Visual Token Compression for Unified Image and ...
[논문 리뷰] Dynamic-VLM: Simple Dynamic Visual Token Compression for VideoLLM
HybridToken-VLM: Hybrid Token Compression for Vision-Language Models ...
PVC: Progressive Visual Token Compression for Unified Image and Video ...
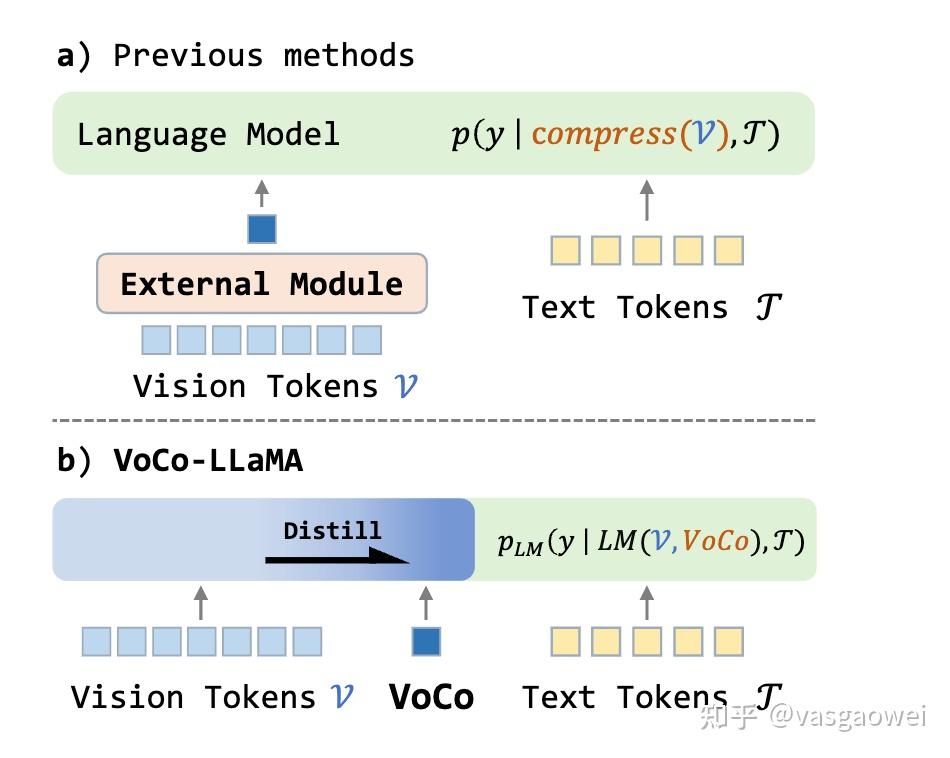
VoCo-LLaMA: Towards Vision Compression with Large Language Models
UniCompress: Token Compression for Unified Vision–Language ...
Vision Tokens vs Text Tokens: Understanding the 10× Compression
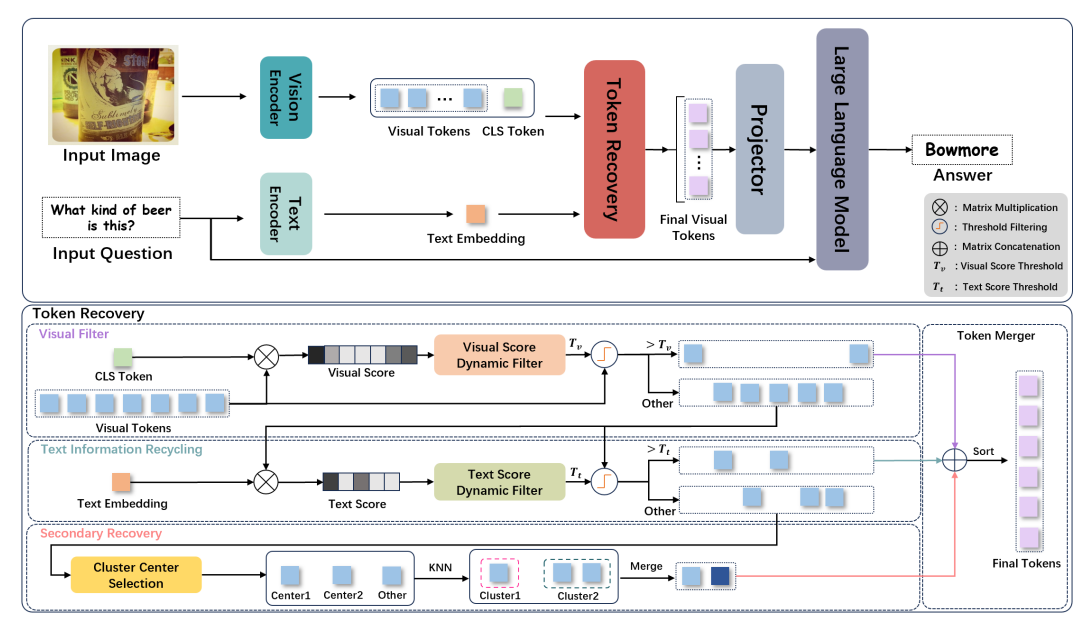
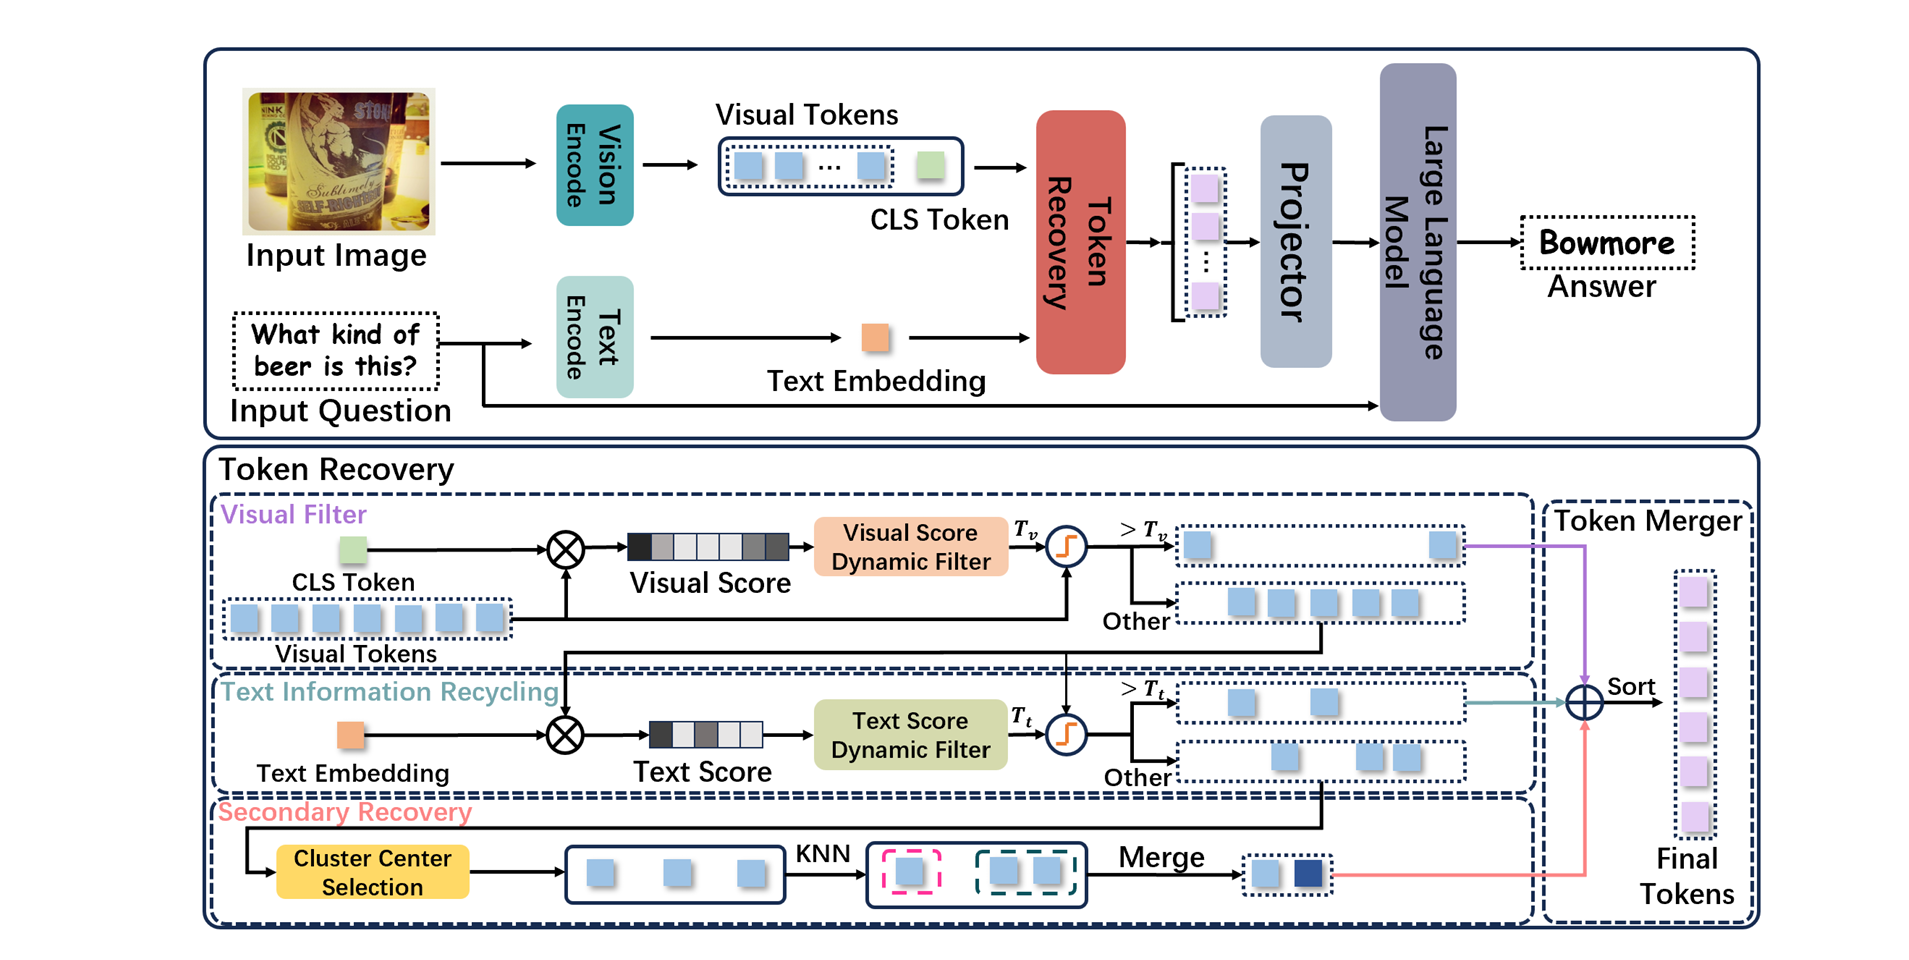
Recoverable Compression: A Multimodal Vision Token Recovery Mechanism ...
Less Is More – Until It Breaks: Security Pitfalls of Vision Token ...
Paper page - PVC: Progressive Visual Token Compression for Unified ...
[论文评述] UHR-BAT: Budget-Aware Token Compression Vision-Language model ...
(PDF) Vision-centric Token Compression in Large Language Model
[论文评述] Lossless Token Merging Even Without Fine-Tuning in Vision ...
CVPR Poster PVC: Progressive Visual Token Compression for Unified Image ...
Vision-centric Token Compression in Large Language Model | alphaXiv
Paper page - Vision-centric Token Compression in Large Language Model
EvoCut: Multi-Layer Evolution-Aware Visual Token Compression for ...
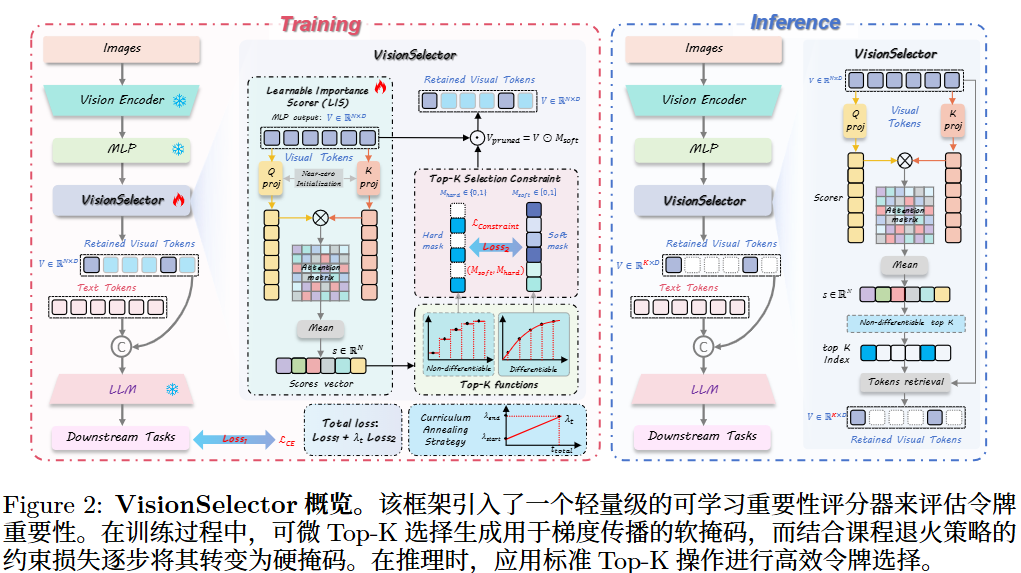
VisionSelector: End-to-End Learnable Visual Token Compression for ...
DeCo: Decoupling Token Compression from Semantic Abstraction in ...
第12篇:多模态大模型论文VISIONTRIM: UNIFIED VISION TOKEN COMPRESSIONFOR TRAINING ...
Dynamic Token Compression for Efficient Video Understanding through ...
Paper page - Vision Token Reduction via Attention-Driven Self ...
[논문 리뷰] LLaVA-Zip: Adaptive Visual Token Compression with Intrinsic ...
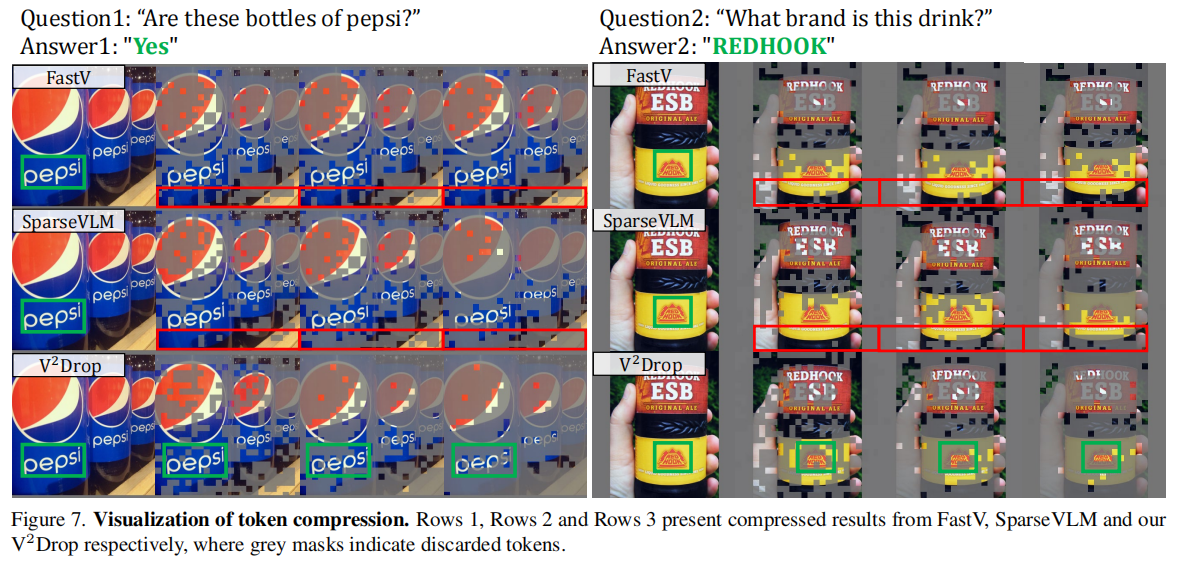
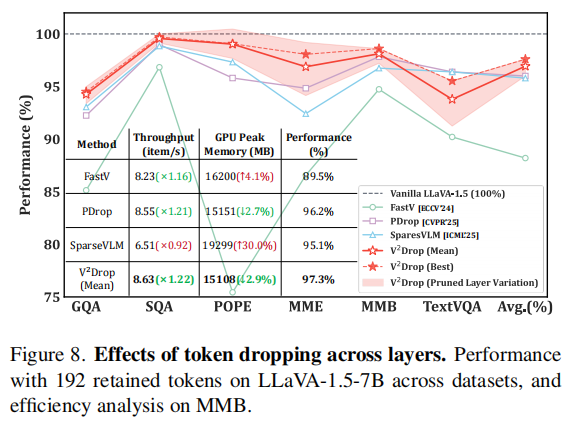
📝 Variation-aware Vision Token Dropping for Faster Large Vision ...
(PDF) Recoverable Compression: A Multimodal Vision Token Recovery ...
[论文评述] Can Visual Input Be Compressed? A Visual Token Compression ...
[2411.10803] Multi-Stage Vision Token Dropping: Towards Efficient ...
(PDF) Top-Down Compression: Revisit Efficient Vision Token Projection ...
InternVideo2.5: Hierarchical Token Compression and Task Preference ...
Paper page - UHR-BAT: Budget-Aware Token Compression Vision-Language ...
Paper page - Dynamic-VLM: Simple Dynamic Visual Token Compression for ...
Paper page - Recoverable Compression: A Multimodal Vision Token ...
FLoC: Facility Location-Based Efficient Visual Token Compression for ...
Contribution-aware Token Compression for Efficient Video Understanding ...
视觉令牌压缩:Vision-centric Token Compression in Large Language Model-CSDN博客
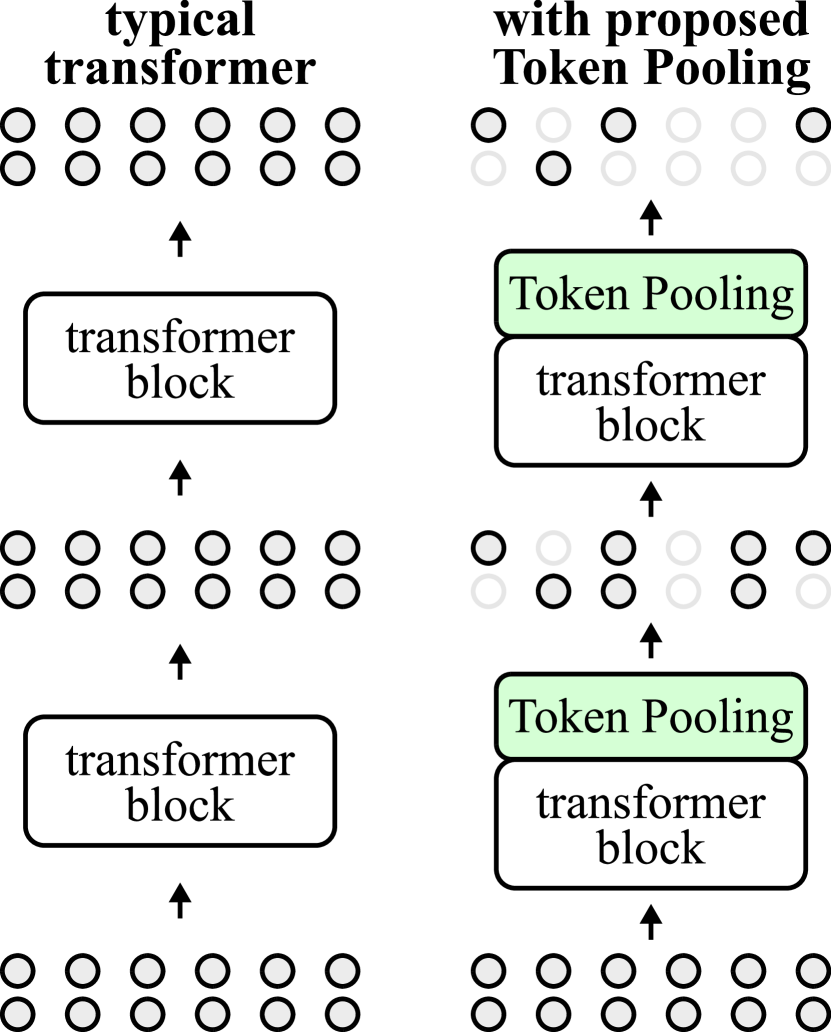
[2110.03860] Token Pooling in Vision Transformers
ECCV Poster Token Compensator: Altering Inference Cost of Vision ...
[论文评述] TC-SSA: Token Compression via Semantic Slot Aggregation for ...
UHR-BAT: Budget-Aware Token Compression Vision-Language model for Ultra ...
Breaking News: DeepSeek Opens Source Again - Vision Compression, 100 ...
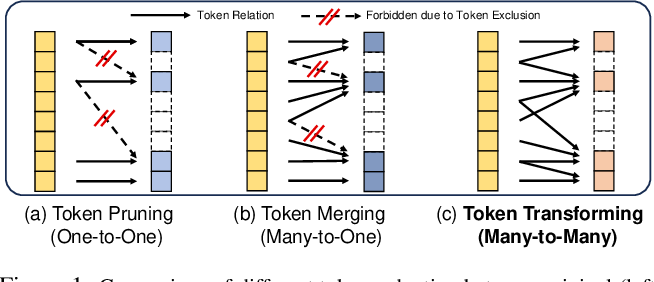
Figure 1 from Token Transforming: A Unified and Training-Free Token ...
Figure 2 from DiffRate : Differentiable Compression Rate for Efficient ...
[논문 리뷰] LaCo: Efficient Layer-wise Compression of Visual Tokens for ...
Token系列:Joint Token Pruning and Squeezing Towards More Aggressive ...
[论文评述] Think Twice, Act Once: Token-Aware Compression and Action Reuse ...
[Revisión de artículo] Token Expand-Merge: Training-Free Token ...
Extreme Model Compression for Edge Vision-Language Models: Sparse ...
Paper page - Token Transforming: A Unified and Training-Free Token ...
Are Vision Tokens all you Need (?) 🧿 This is a fantastic blog from ...
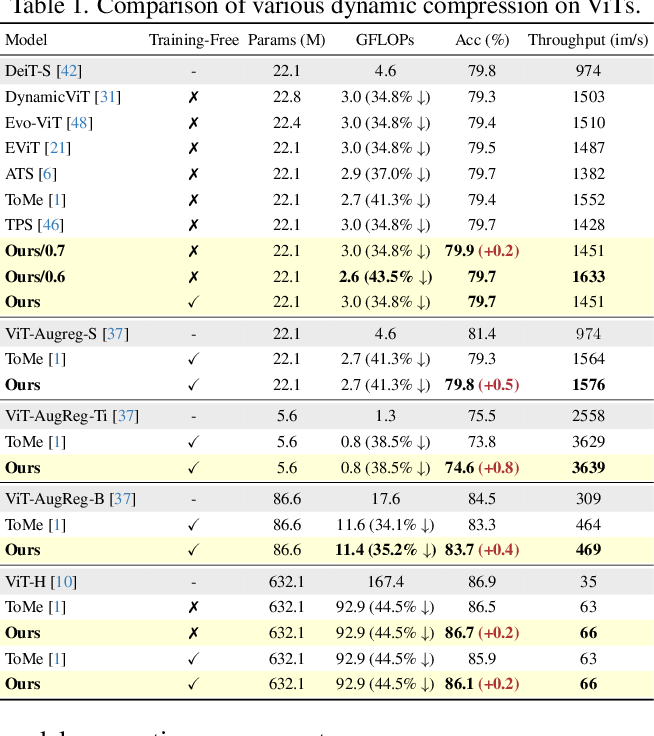
Table 1 from Token Transforming: A Unified and Training-Free Token ...
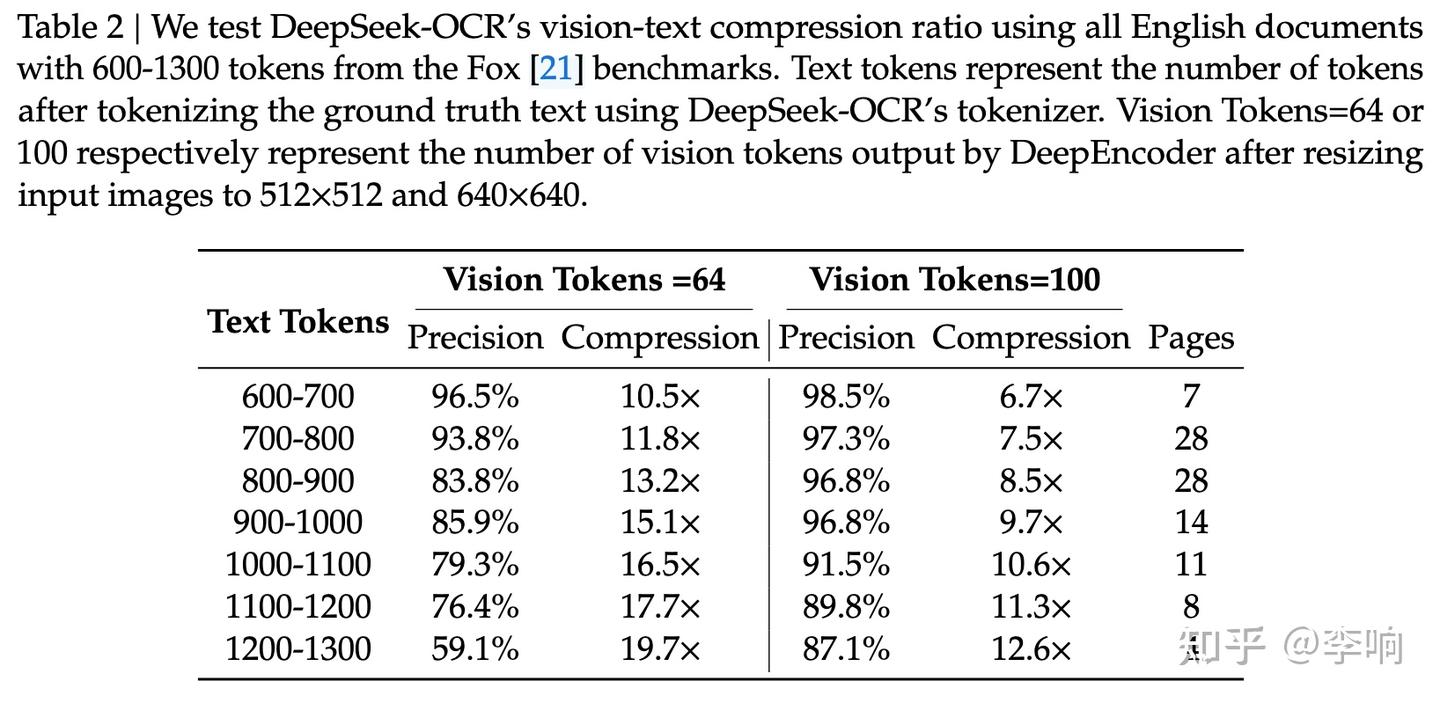
DeepSeek new paper: model uses images of text for vision tokens instead ...
GitHub - OpenGVLab/PVC: [CVPR 2025] PVC: Progressive Visual Token ...
How to buy Vision Token? - Crypto Mitumit
Paper page - A Glimpse to Compress: Dynamic Visual Token Pruning for ...
Fourier-VLM: Compressing Vision Tokens in the Frequency Domain for ...
PaperReading-120 DeepSeek-OCR:Contexts Optical Compression 使用输入文本图片的方式来 ...
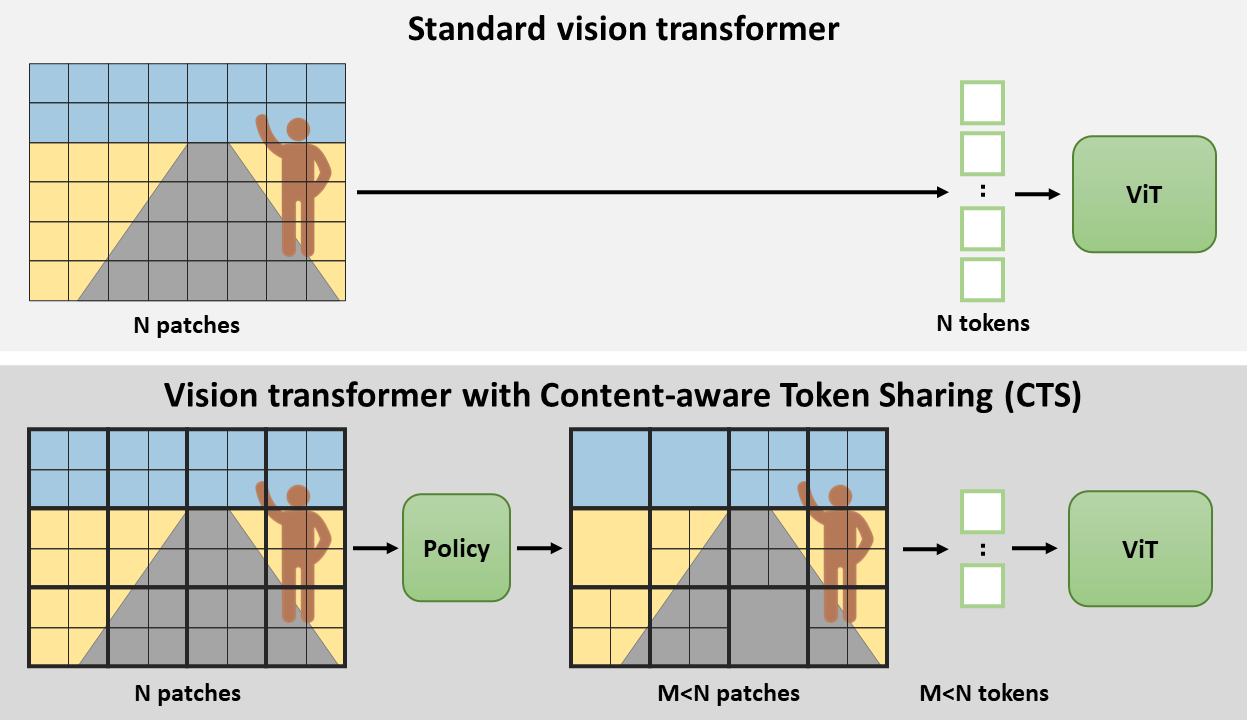
Content-aware Token Sharing for Efficient Semantic Segmentation with ...
Jian Xu (徐健)'s Homepage
VoCo-LLaMA:多模态大语言模型中的视觉Token压缩 - 知乎
Wentong Li|NUAA
[논문 리뷰] On the Adversarial Robustness of Large Vision-Language Models ...
[2503.17349] Beyond Semantics: Rediscovering Spatial Awareness in ...
GitHub - cokeshao/Awesome-Multimodal-Token-Compression: [TMLR 2026 ...
translorentz/vision-token-compression-bench · Datasets at Hugging Face
On the Adversarial Robustness of Large Vision-Language Models under ...
CSU-JPG Lab | Vision-centric MLLM
Yi Chen | AI for Adjuvant Design
深度解读 DeepSeek-OCR 论文:通过视觉模态实现高效文本压缩_deepseek-ocr论文-CSDN博客
[2306.01733] DocFormerv2: Local Features for Document Understanding
[2026-01-29] VTC-R1: 텍스트를 이미지로 압축하는 '광학 메모리' 혁신 - 롱 컨텍스트 추론의 병목을 해결하는 ...
GitHub - Shimmer22/VisionTrim-qwen: REPODUCTION of [ICLR 2026] Official ...
Figure 1 from Make Your ViT-based Multi-view 3D Detectors Faster via ...
EffiVLM-Bench: A Comprehensive Benchmark for Evaluating Training-Free ...
GitHub - banjiuyufen/RecoverableCompression: Recoverable Compression: A ...
Vision-Language Models & CLIP | LeetLLM
Paper page - FCoT-VL:Advancing Text-oriented Large Vision-Language ...